GEO Check:ChatGPT、Claude、Gemini 和 DeepSeek 会推荐你的品牌吗?
GEO Check 如何衡量品牌在 AI 回答里的可见度:6 个买家问题问 4 个 AI 模型,统计被提及率、声量占比、被推荐的竞品,并做 9 项站点就绪检查,给出行动清单。
以前,买家会在 Google 里搜“自由职业者最好用的开票软件”。现在,越来越多人直接在对话框里问同一个问题。Google 给十条链接,AI 助手只给一个回答,里面通常就三四个名字。如果你的品牌不在其中,这次访问还没开始就已经丢了,而且任何统计工具都不会告诉你。
Growth Atlas 的 GEO Check 就是用来给这个盲区量化打分的。贴上你的网址,它会推断你的买家会问 AI 什么问题,拿每个问题去问四个模型,然后告诉你:它们多常提到你、推荐了谁而不是你、网站上该改什么。
下面用 GEO Check 页面上的示例报告,把每个数字讲清楚,也直说这项检查能说明什么、不能说明什么。
先说结论
- GEO Check 写出 6 个不提你品牌的买家问题,分别问 GPT-6.1 Sol、Claude Sonnet 5.5、Gemini 3.8 Flash 和 DeepSeek V4 Flash 四个模型,每次共 24 个回答。
- GEO 总分 = 40% AI 可见度 + 20% 声量占比 + 10% 平均排位 + 30% 站点就绪度。
- 站点就绪度是对线上首页、robots.txt 和 llms.txt 的 9 项检查,包括 GPTBot、ClaudeBot 等 AI 爬虫有没有被放行。
- 每个回答都完整展示,并标出其中提到的品牌,每个数字都能自己核对。
- 模型基于训练数据作答,不联网搜索。打开联网搜索的 ChatGPT 或 Gemini 可能给出不同答案。
先简单说说 GEO
生成式引擎优化(GEO)就是让你的品牌出现在 AI 的回答里,并被推荐。SEO 争的是链接列表里的一个位置,GEO 争的是 AI 唯一那个回答里的一次提名。
两者有重叠:页面清晰、有结构化数据、在评测网站上口碑好,对两边都有帮助。但一个页面可以在 Google 排得很好,却在 AI 回答里完全缺席;反过来也一样。
要填什么
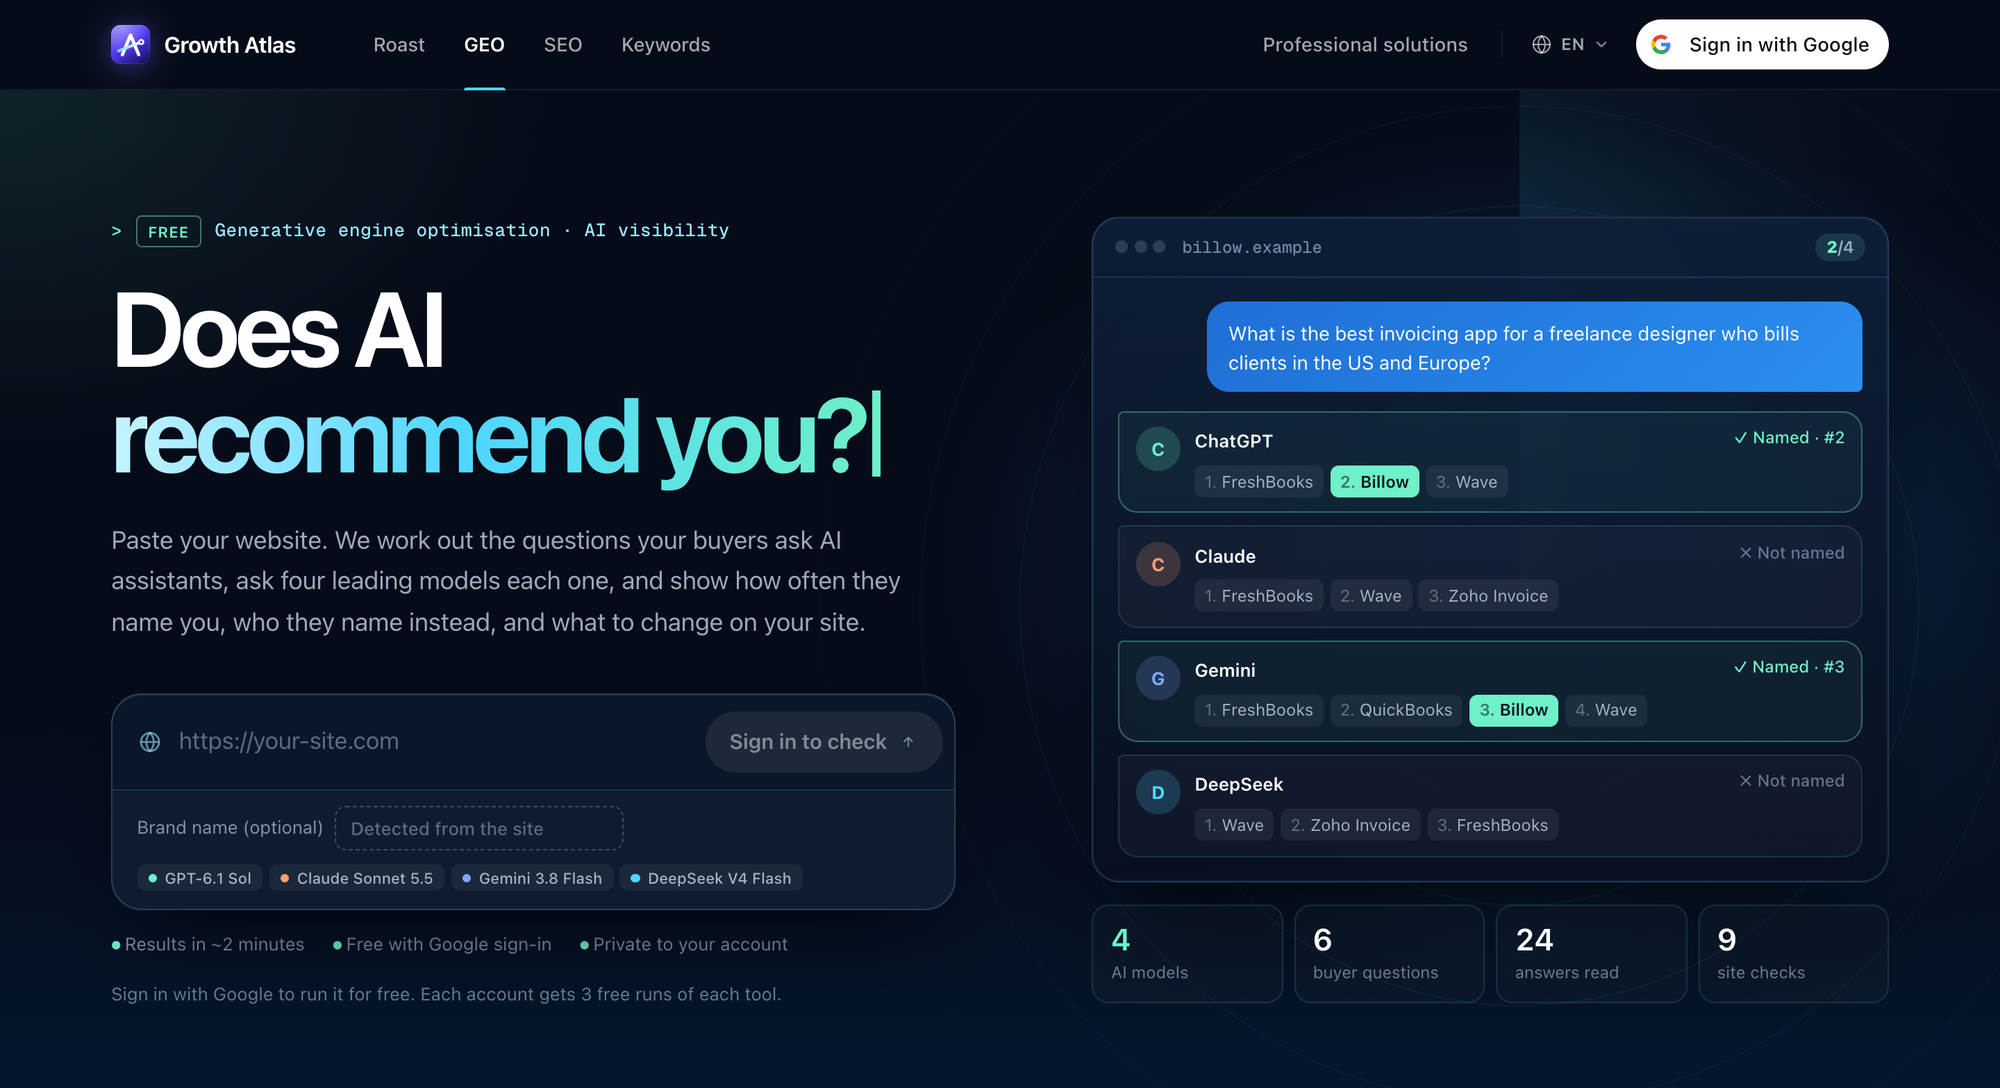 2026-11-20 的 GEO Check 表单。右侧预览来自示例报告的一个问题:四个模型里有两个提到了“Billow”,分别排第 2 和第 3。
只需要一个网址。品牌名可以不填,默认从网站上识别。如果你的品牌名和域名不一样,或者大家更熟悉你的产品名,就手动填上。
一次检查怎么跑
- 读取。 加载你的公开首页、robots.txt 和 llms.txt,跑 9 项就绪检查。
- 提问。 由一个模型推断你的品牌、品类、可能的竞品,并写出 6 个买家问题。这些问题绝不点你的名,因为要看的就是 AI 会不会自己想到你。GPT、Claude、Gemini 和 DeepSeek 各自在全新对话里回答每一个问题。
- 打分。 从回答里统计提及次数、排位和声量占比;分析模型判断回答对你的语气,并写出行动清单。
6 个问题按真实买家的意图来配:2 个“哪款 X 最适合 Y”,1 个具体使用场景,1 个“[最知名竞品] 的替代品”,1 个竞品之间的对比,再加 1 个只描述痛点、不直接要产品的问题。示例里的问题,从“为美国和欧洲客户开票的自由设计师,用什么开票软件最好?”到“客户总是拖好几周才付款,怎么才能更快收到钱?”。
最后这类痛点问题通常最难拿下。买家还没决定要买软件,AI 往往先给建议,最多顺带提一两个产品。
GEO 总分怎么算
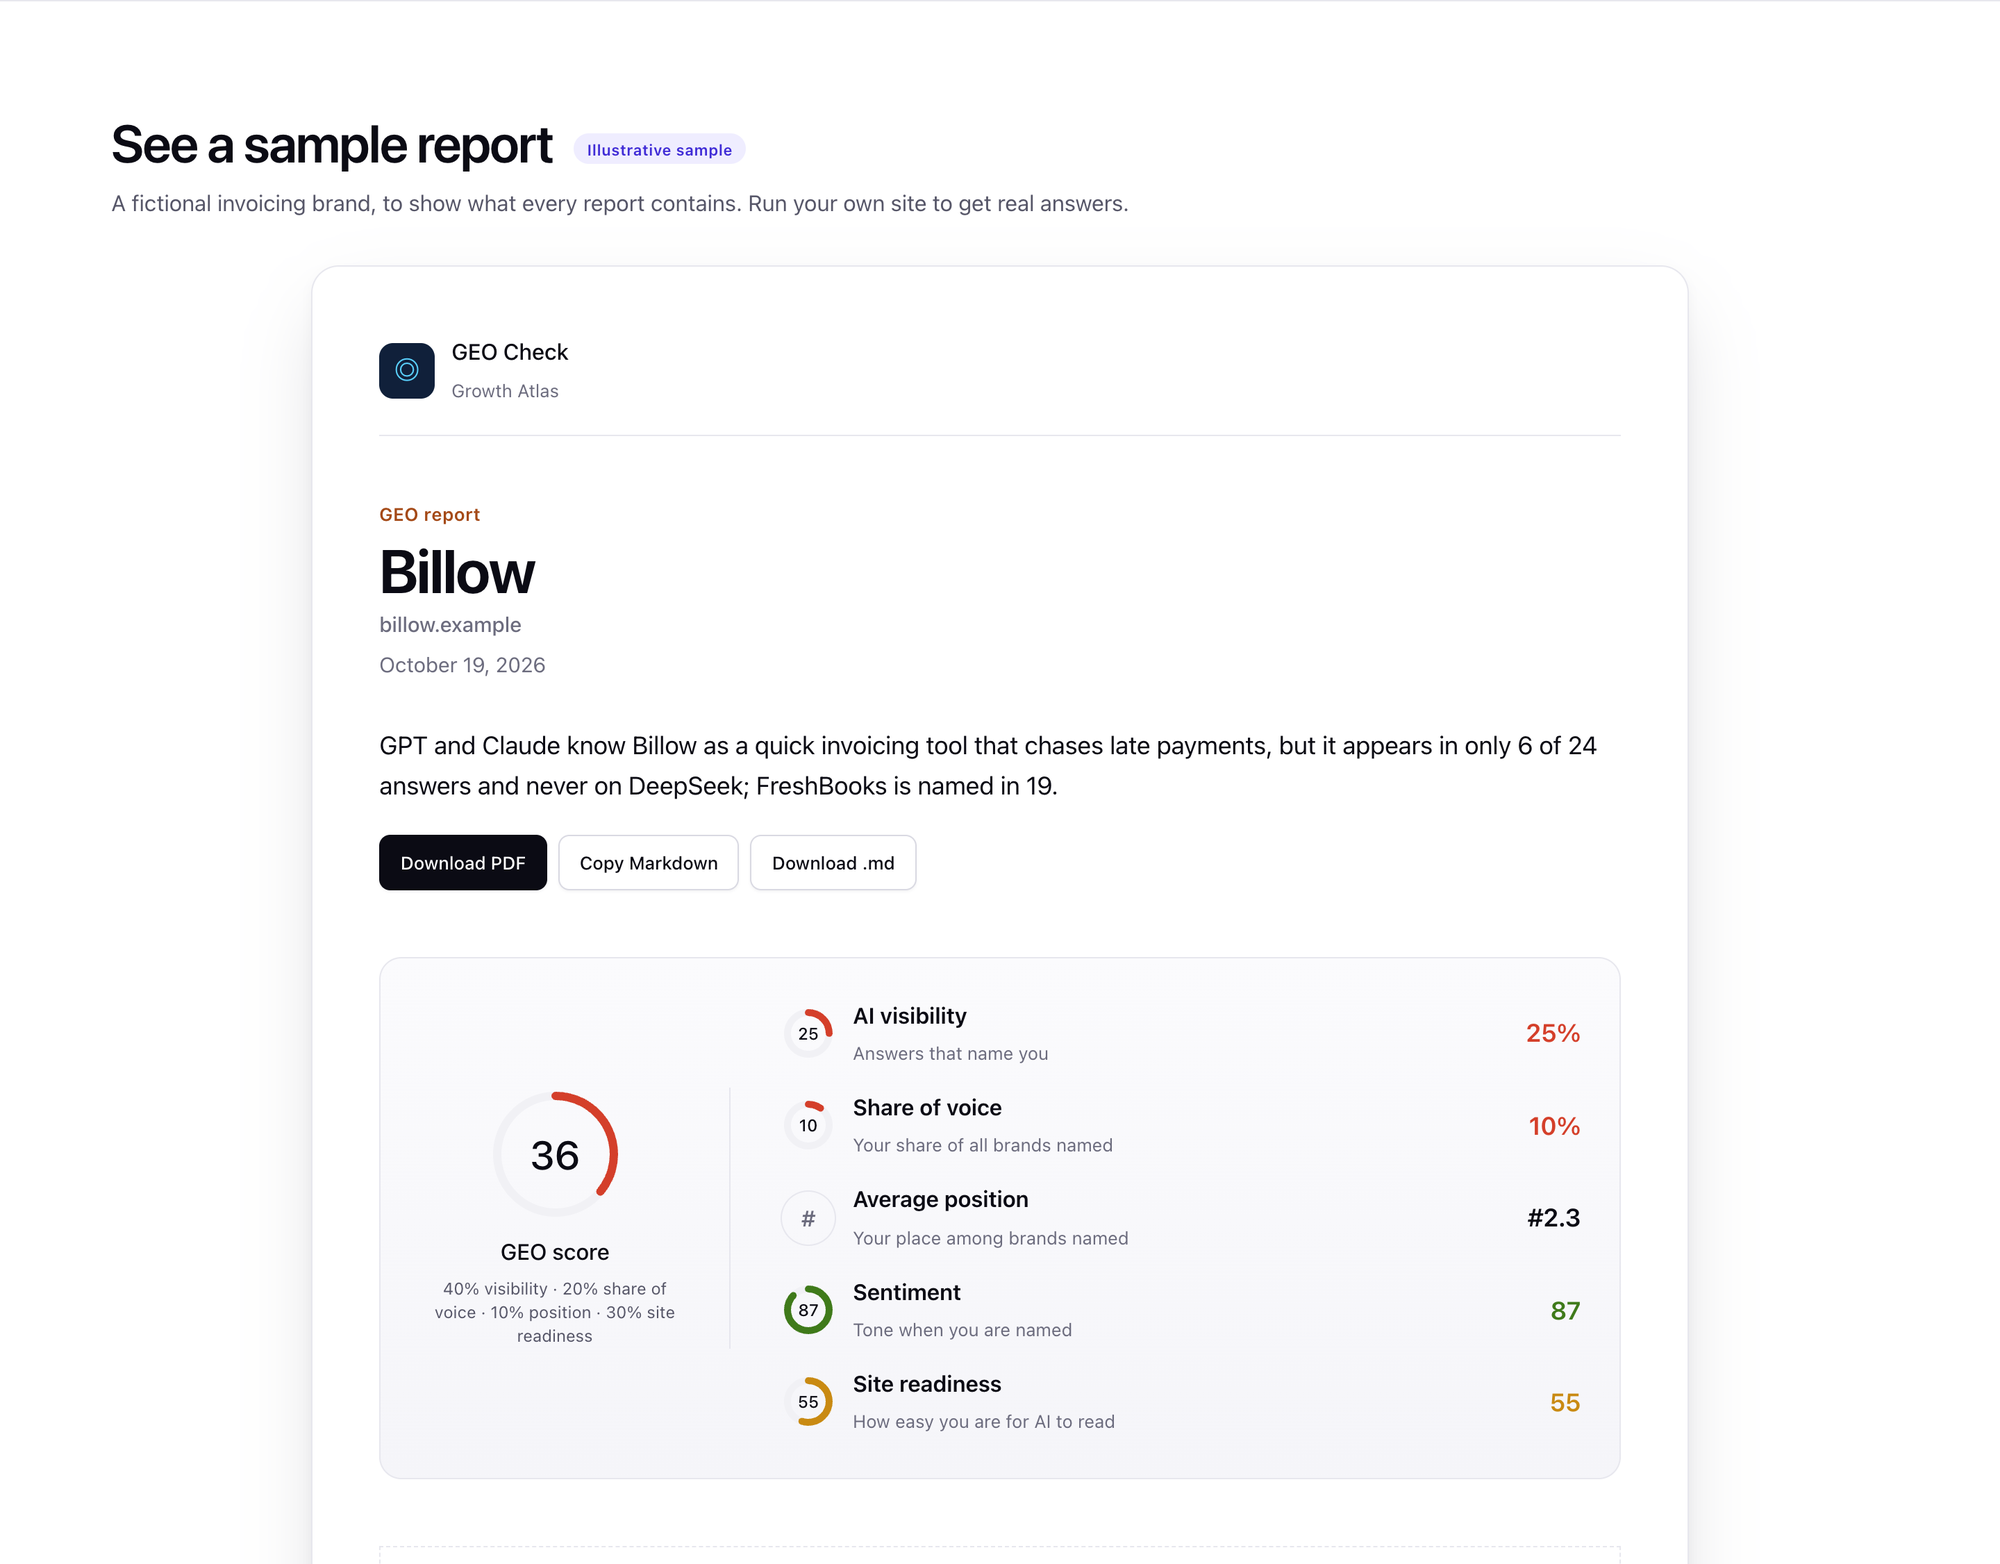 示例报告(虚构的开票品牌“Billow”)。摘要写明:它只出现在 24 个回答中的 6 个,DeepSeek 一次都没提;而 FreshBooks 被提到 19 次。
总分由四部分组成:
| 部分 | 衡量什么 | 权重 |
|---|---|---|
| AI 可见度 | 提到你的回答占比 | 40% |
| 声量占比 | 你被提及次数占所有品牌提及的比例 | 20% |
| 平均排位 | 你在回答所列品牌中的位置 | 10% |
| 站点就绪度 | 网站对 AI 是否友好(9 项检查) | 30% |
情感分(提到你的回答语气如何)会显示在旁边,但不计入总分。
示例的数字可以验算:可见度 25(24 个回答中 6 个),声量占比 10。排位部分第 1 名记 100 分,每往后一名少 20 分,平均排位 2.3 对应 74 分。站点就绪度 55。合起来:0.4 × 25 + 0.2 × 10 + 0.1 × 74 + 0.3 × 55 = 35.9,显示为 36。
换成大白话:最要紧的是被提到;排第一远没有“经常被提到”重要;而总分里大约三分之一,今天就能靠站点就绪检查自己改上去。
按模型看可见度
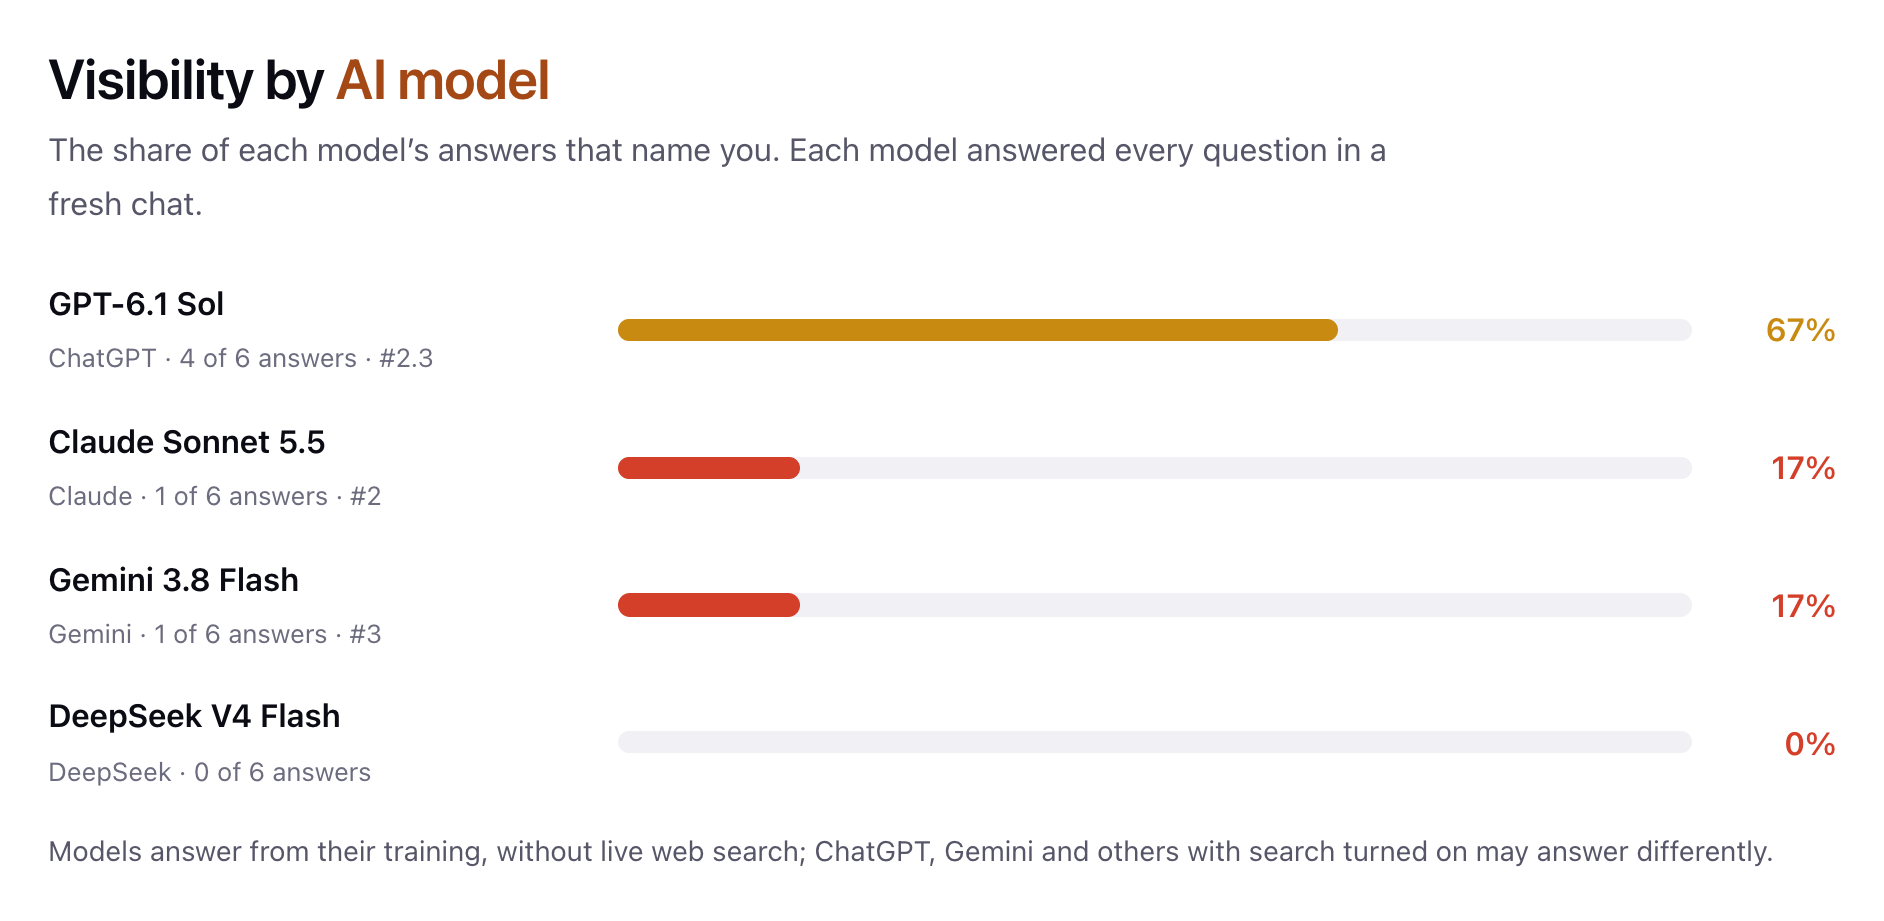 示例中各模型的可见度。图下那行小字是整份报告最重要的前提:模型基于训练数据作答,不联网搜索。
按模型拆开,往往比总数更有用。不同模型的训练数据和时间不同,一个品牌可能某个模型很熟,另一个完全不知道。示例里,GPT 6 次里提了 4 次 Billow,DeepSeek 一次都没有。
不同的差距指向不同的改法。如果一个模型认识你、另一个不认识,问题通常出在那个模型学习过的信息源里你的覆盖不够,属于权威度问题(榜单、评测、其他网站的提及)。如果所有模型都不认识你,就先从基础做起:网站怎么介绍你自己,爬虫能不能读到。
图下面是所有回答中出现过的品牌排名。示例里 FreshBooks 出现在 79% 的回答中,Billow 排第四,25%。这张表才是你在 AI 回答里真正的竞品名单,常常和你在 Google 上盯着的那几家不一样。
你还可以展开每个问题,完整阅读四个模型的回答,看到在哪里提到了你、排第几。可见度、声量占比和排位这几个数字,都能追溯到这些回答。
真实运行时,报告还可能多出一个示例里没有的板块:Ahrefs 统计的“AI 回答引用(链接到)你域名页面的次数”,按助手拆分,包括 ChatGPT、Google AI Overviews、Google AI Mode、Perplexity、Gemini、Copilot 和 Grok。这部分数据来自 Ahrefs 对真实提问的追踪,包含带搜索的助手;统计的是指向你网站的链接,不是品牌名被提到的次数。只有 Ahrefs 见过你的域名被引用时,这个板块才会出现。
站点就绪度:你能直接控制的部分
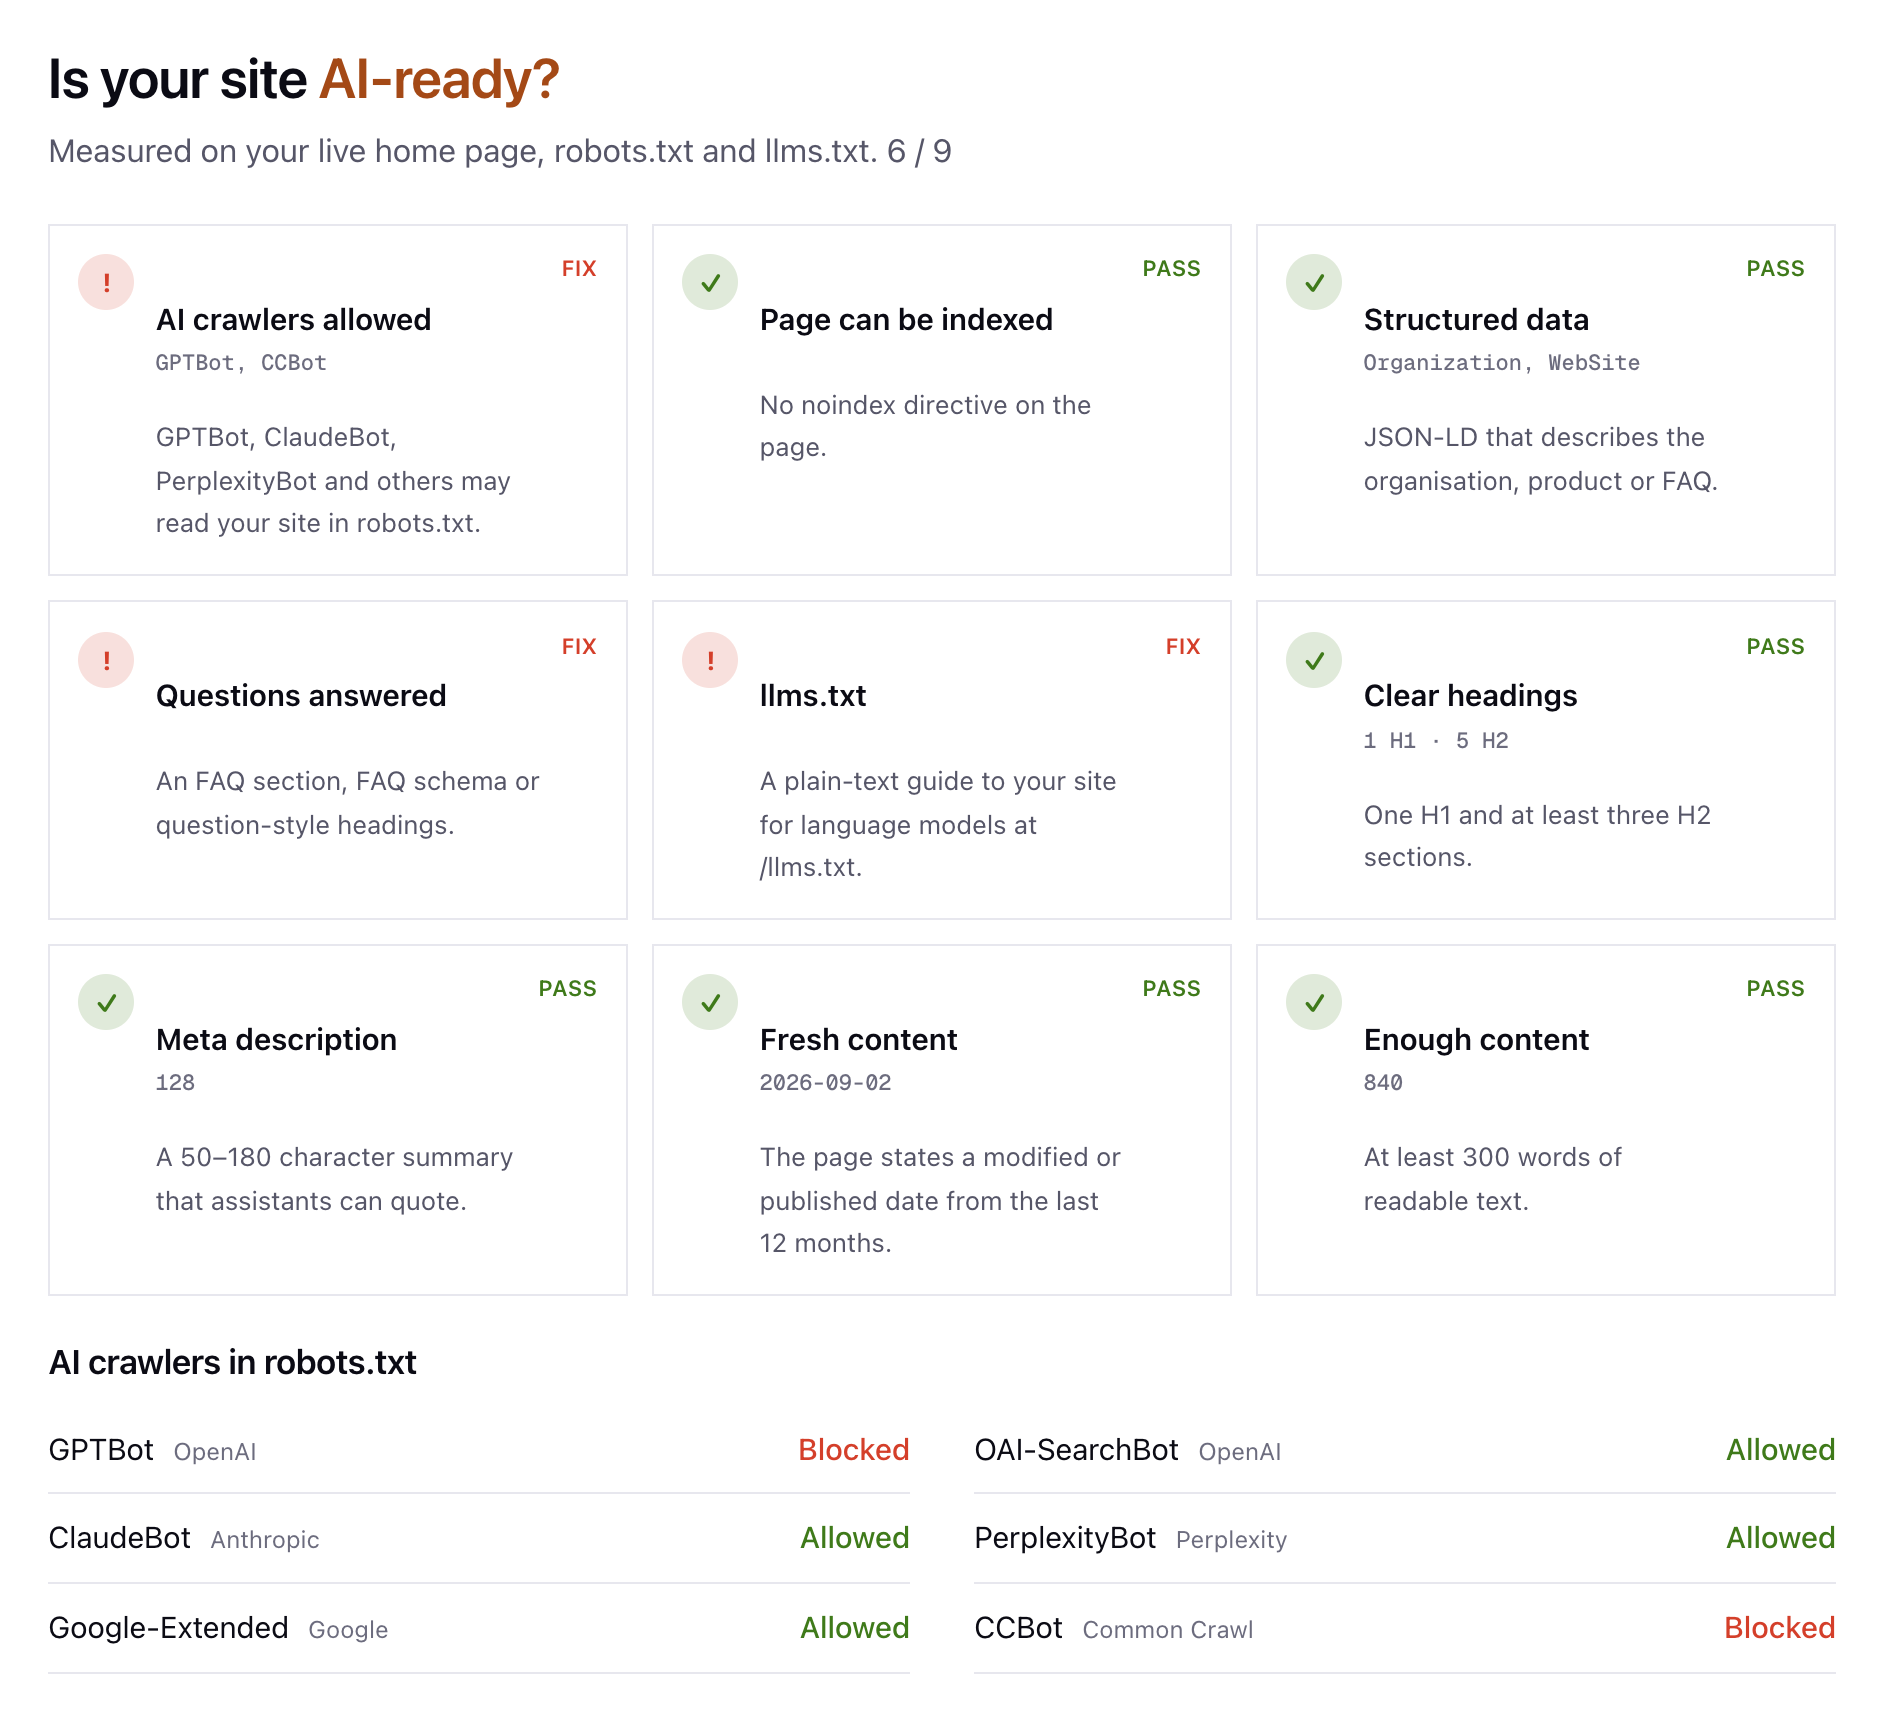 示例的站点就绪度:9 项通过 6 项。robots.txt 表显示 GPTBot 和 CCBot 被屏蔽,其余四个 AI 爬虫放行。
9 项检查都在线上首页、robots.txt 和 llms.txt 上进行,各有权重,加起来是 100:
| 检查项 | 通过条件 | 权重 |
|---|---|---|
| AI 爬虫放行 | robots.txt 没有屏蔽 GPTBot、OAI-SearchBot、ClaudeBot、PerplexityBot、Google-Extended、CCBot | 25 |
| 可被索引 | 没有 noindex | 15 |
| 结构化数据 | 页面上有任意 JSON-LD(例如 Organization、Product、FAQPage) | 15 |
| 问题解答 | 有 FAQ 区块、FAQ schema 或问句式标题 | 10 |
| llms.txt | /llms.txt 有一份写给语言模型的纯文本说明 | 10 |
| 清晰标题 | 1 个 H1,至少 3 个 H2 | 10 |
| Meta 描述 | 50–180 字符的摘要 | 5 |
| 内容新鲜 | 页面标有最近 12 个月内的发布或更新日期 | 5 |
| 内容充足 | 至少 300 词可读文本 | 5 |
示例里有三项没过:AI 爬虫(25)、问题解答(10)、llms.txt(10),共 45 分,所以就绪度是 55。
AI 爬虫这项权重最高,而修复往往只是改 robots.txt 里的一行。屏蔽 GPTBot 或 CCBot 的规则如果不是你自己写的,很容易被忽略。CCBot 为 Common Crawl 抓取数据,而很多模型都用它训练。不过改规则之前要想清楚:放不放行 AI 爬虫,是关于你内容的商业决定,不只是 GEO 技巧。
行动清单
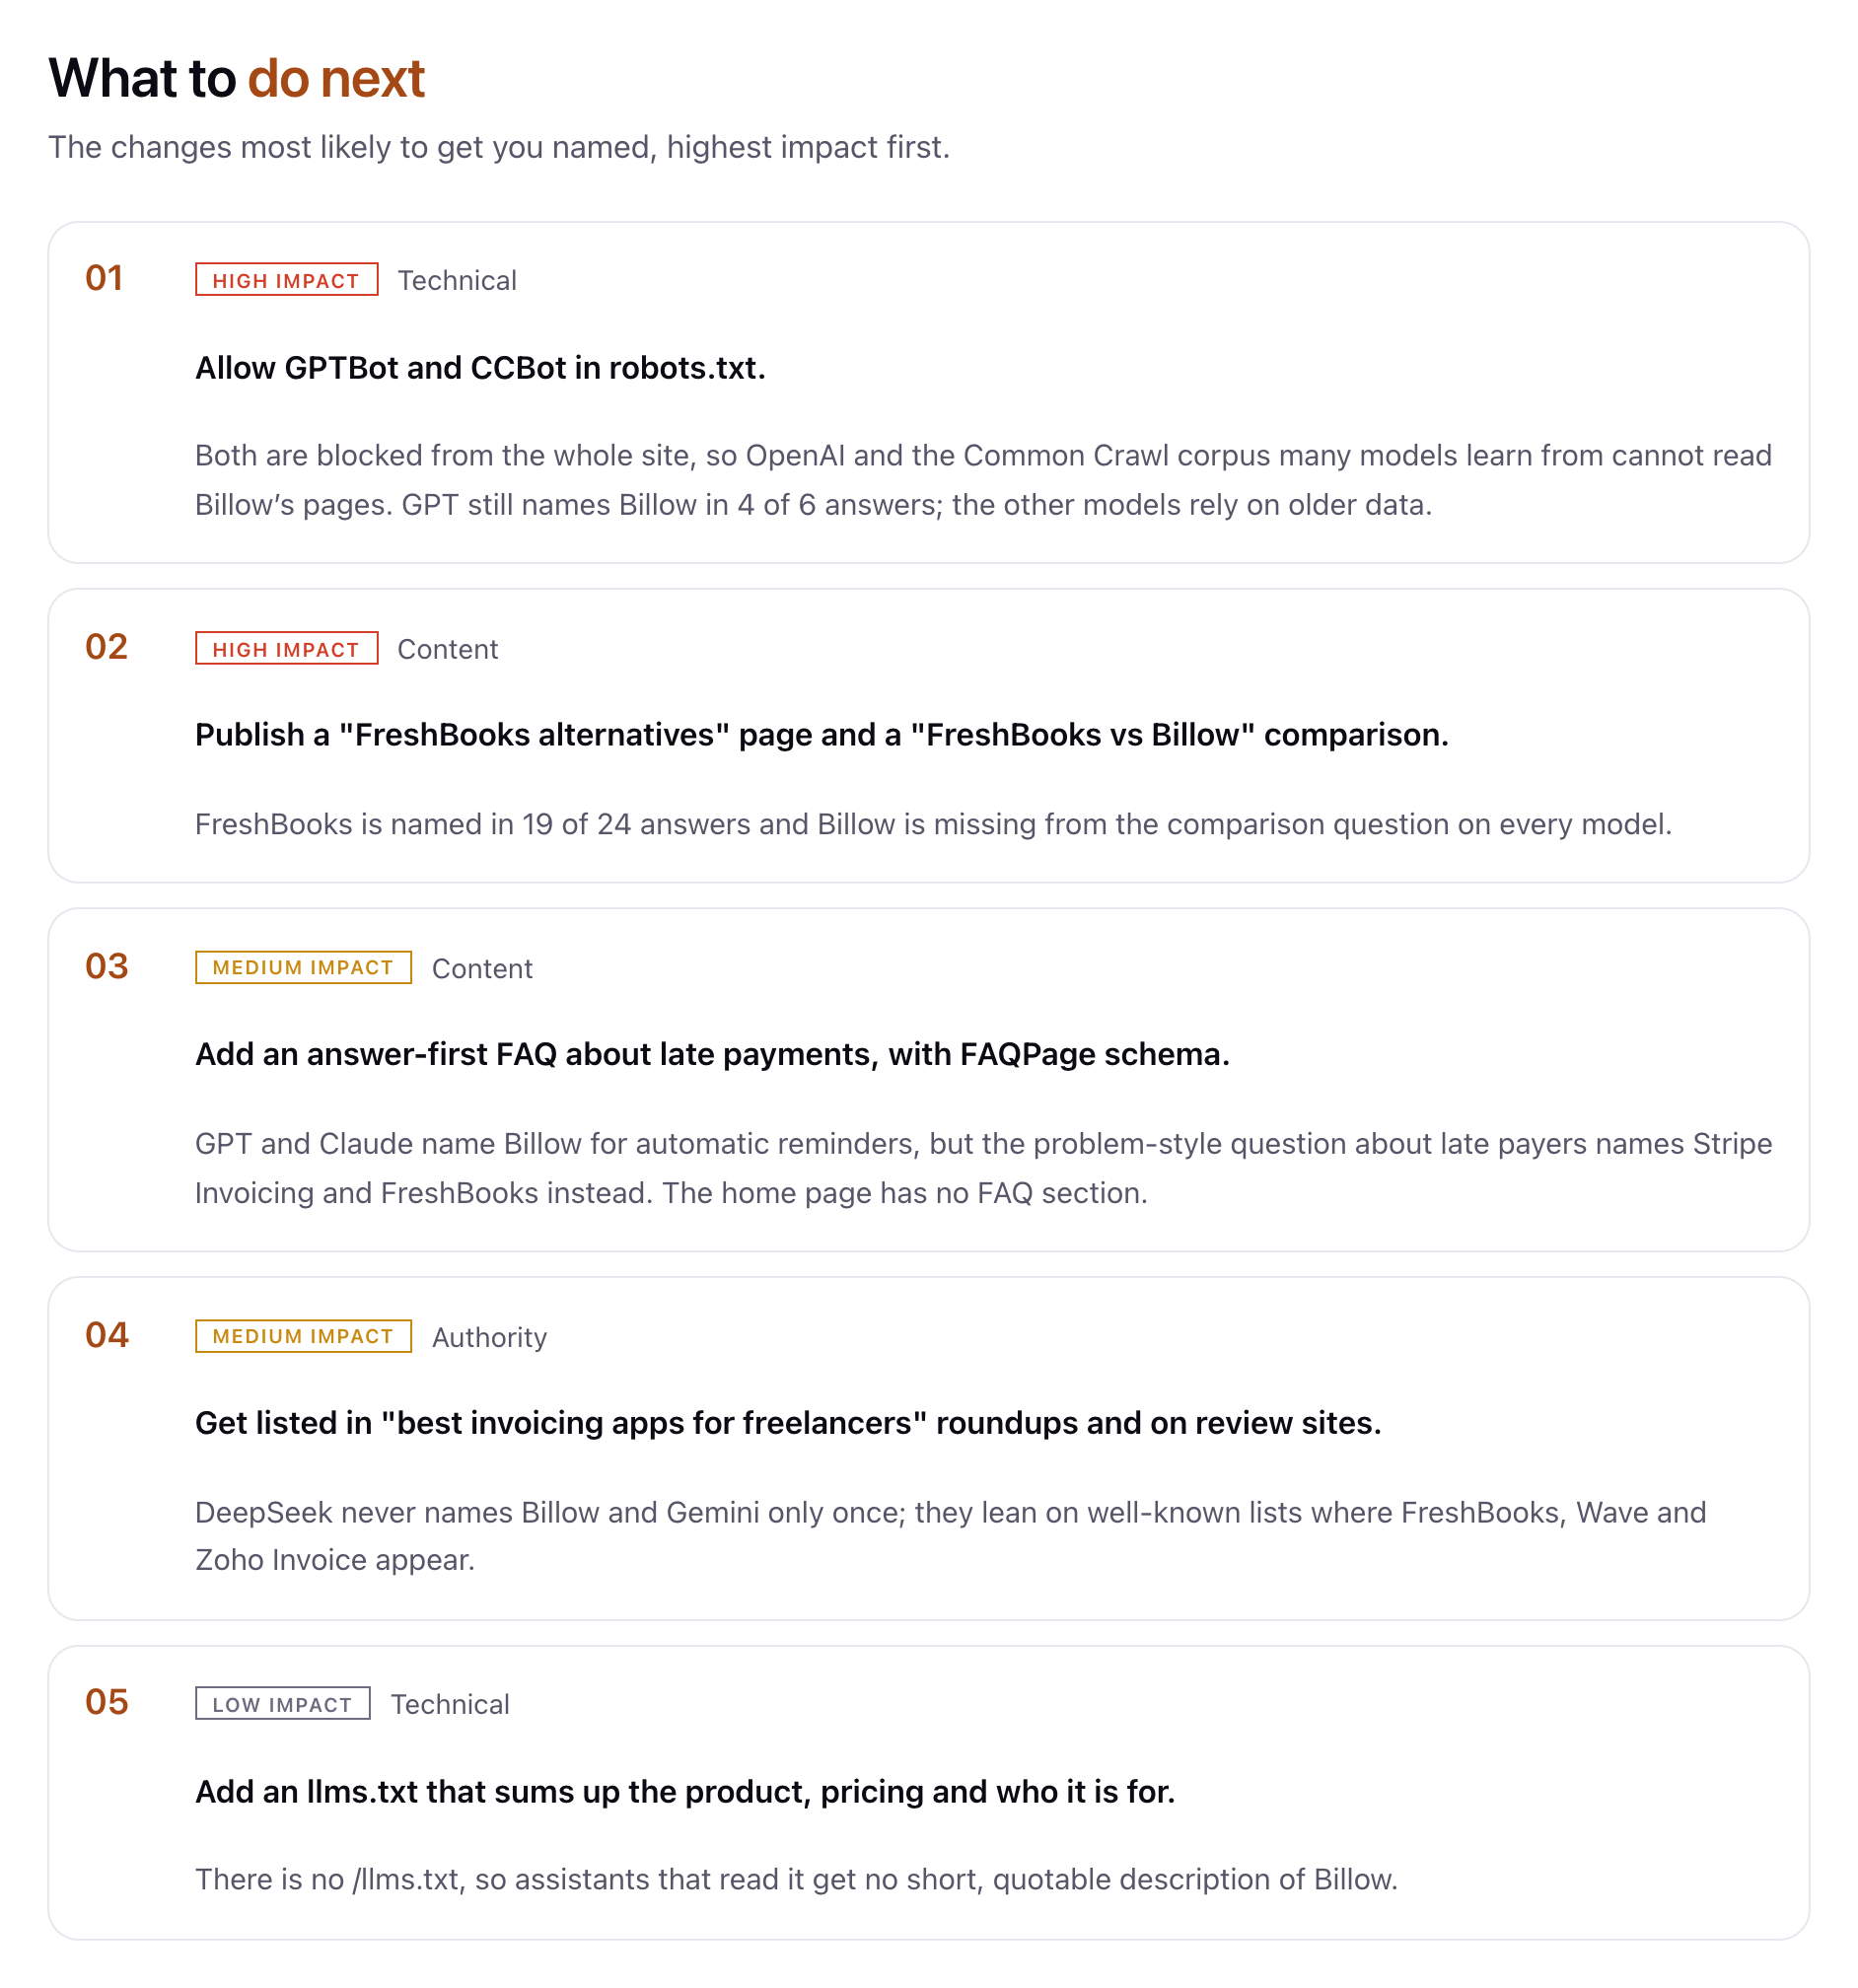 示例的行动清单。每项标注影响(高、中、低)和类型(技术、内容、权威),理由都指向上面的具体问题或检查项。
报告最后给出 4 到 6 项行动,影响最大的排前面。每项分为三类:技术(爬虫、schema、llms.txt)、内容(对比页、FAQ 回答)、权威(出现在 AI 了解你所在品类的那些地方),理由都和前面的证据对应。
示例把这个逻辑展示得很清楚。赢下最多回答的竞品 FreshBooks,成了内容类行动的主题,要做一个“FreshBooks 替代品”页面和一个“FreshBooks vs Billow”对比页。从不提这个品牌的模型,则引出了权威类行动,也就是争取进入这些模型依赖的榜单和评测网站。
怎么用好 GEO Check
- 先跑一次当基线,等有实质改动再跑。 3 次免费额度可以这样分:基线一次,技术修复后一次,新内容上线几个月后一次。基于训练数据的回答变化很慢,别指望内容改动几天内就体现出来。
- 读回答,别只看分数。 模型怎么描述你,和提不提你一样重要。如果它们说你是“开票工具”,而你卖的是收款,那是定位问题。
- 识别错了就手动填品牌名。 如果报告里的品牌或品类不对,填上品牌名再跑一次。
- 和 KeywordScout 搭配。 你丢掉的那些问题,往往对应着某些搜索词。KeywordScout 能告诉你这些词在 Google 上有没有搜索量,这样一个页面可以同时争取两边。
GEO Check 说明不了什么
- 它不是某个用户屏幕的原样复制。 模型通过 API 被提问,不联网搜索,也没有用户历史。打开联网搜索或有个性化的助手,回答可能不同。
- 6 个问题只是样本。 它覆盖主要意图,不是你市场里的每个问题。模型每次回答也会有波动,两次运行之间差一两次提及,属于正常噪音。
- 按名字识别提及。 分析模型会合并常见写法,但品牌名比较通用的话,可能多算或少算。数字看着意外时,去读原回答。
- 不做长期追踪。 每次运行都是一张快照。想看变化,在 History 里对比两份报告。
常见问题
GEO Check 问的是哪些模型? 截至 2026-11-20:GPT-6.1 Sol(ChatGPT 系列)、Claude Sonnet 5.5、Gemini 3.8 Flash 和 DeepSeek V4 Flash,通过 SandBase 调用。每个模型在 SandBase 上都有详情页,例如 GPT-6.1 Sol。
结果和 ChatGPT 里看到的一样吗? 不完全一样。那 24 个回答衡量的是模型在不联网时对你的了解。带搜索的 ChatGPT、Google AI Overviews 和 Perplexity 还会实时抓取网页,回答可能不同。报告里可选的 Ahrefs 引用板块,反映的才是带搜索助手的情况。
免费吗? 免费。用 Google 登录后有 3 次免费运行。
能查竞品吗? 能。输入对方网址,报告会显示 AI 多常提到他们、又推荐了谁。
报告会保存吗? 保存在你账号的 History 里,只有你能看,可以随时删除。
动手试试
用 GEO Check 查查你的网站,看看你的买家会读到什么样的回答。想了解它和网站诊断、SEO、关键词工具怎么配合,见 Growth Atlas 总览。
来源:growatlas.ai/tools/geo 及其示例报告(虚构品牌“Billow”,2026-10-19),2026-11-20 获取。模型、权重和检查项可能调整,以线上工具页为准。